上下文变换:设计如何改变上下文的形态
广度挑选构件,深度为每个构件定价。设计手法通过削减、迁移、索引或使其可检查来变换上下文。
本文为中文版,根据英文原版改写,而非逐句直译。
前两篇介绍了上下文成本的两种基本形态。深度是理解一个焦点构件的结构成本。广度是获取一次真实修改的修改闭包的成本,修改闭包指的是为保证修改正确而必须一起变化的那组构件。
本篇把两者放在一起,用它们来回答一个新问题:当一个设计手法让未来的修改变得更容易时,它实际上做了什么?
广度挑选构件,深度为每个构件定价
一张图就能概括这种双形态视角。
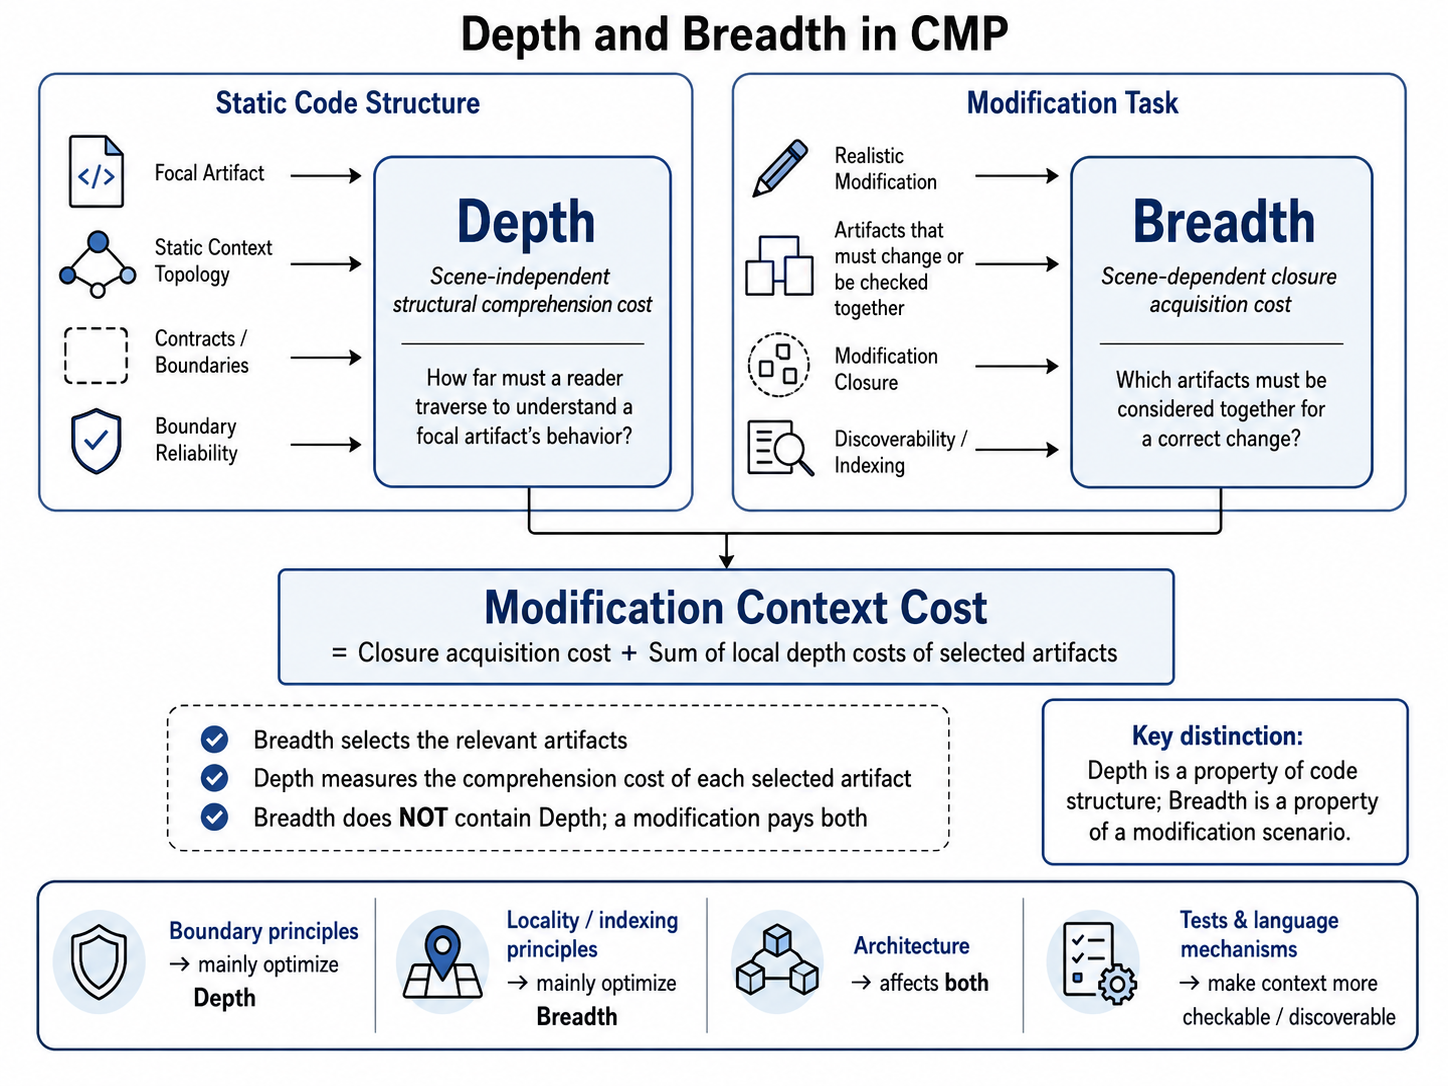
图 1. 深度属于静态代码结构,广度属于修改场景。一次真实的修改两者都要支付:获取相关闭包的成本,加上所选构件各自的局部深度成本。(图片由 GPT Image 2 生成。)
任何一次真实的修改都要回答两个不同的问题。哪些构件属于这次修改?这是广度。对其中每个构件,修改者需要多少局部上下文才能安全地编辑或验证它?这是深度。实践中两者相互交织:读一个构件时,常常会发现另一个属于闭包的构件;每个新加入的闭包成员,又带来它自己的局部上下文问题。但在概念上,这两种成本始终是分开的。广度挑选构件,深度为每个构件定价。
这种区分有实际意义。一个代码库的构件可能个个都容易在局部理解,修改起来却依然危险,因为“一起变化”的关系散落各处。反过来,一个代码库的修改也可能很好地局限在少数位置,但被选中的构件各自都很难理解。这是两类不同的问题,设计必须分别应对。
设计重塑上下文:削减、迁移、索引、检查
设计很少能让上下文消失,更多时候是在变换上下文(context transformation):同样的信息换了一种形态,换了一个位置,或者通过另一条路径呈现出来。原本在几处重复的决策,可以合并成一个有名字的抽象;复杂的实现细节,可以挪到边界后面;一组相关构件可以继续分散,但通过一条显式路径变得可发现;原本隐含的假设,可以写进测试、类型、schema 或协议,从而变得可检查。在这些情况下,系统包含的信息总量未必变少,变化的是获取上下文的形态。
这就是把 CMP 应用到单个设计手法上。CMP 判断一种设计是否优于另一种,看的是获取正确修改所需的充分上下文是否更便宜。把同一原则用于单个手法而不是整个设计,就得到一条检验标准。
一个设计手法有价值,当且仅当它把所需上下文变换成更便宜的获取形态。
这里的“便宜”沿用 CMP 赋予它的操作性含义:取决于规模和可发现性。具体来说,设计手法可以通过几种不同的方式让上下文更便宜:有时是构件更少,有时是停止点更好,有时是分散构件之间的关系更显眼,有时是把脆弱的假设变成可执行的反馈。
这四种情形对应设计手法可以执行的四种基本变换。削减(reduce)把重复的决策合并到一个有归属的地方,缩小修改者必须获取的集合。迁移(relocate)把细节挪到边界后面,让读者在停止点支付较小的表面成本,而不是较大的内部成本。索引(index)让闭包保持分散,但使其成员能够被一起找到,把开放式搜索变成有界的获取。检查(check)把假设移入测试、类型、schema 或校验器,让缺失的部分以失败的形式暴露,而不是成为静默的缺陷。
这四者并不互斥:一个设计手法可以同时削减某个闭包、引入一道边界、建立一个索引,并让部分假设变得可检查。重点不在于把每种技术精确地归入某一类,而在于看到设计改变的是获取路径,而不只是代码的外观。
每一种变换都是拿一种成本换另一种成本
每种变换都有代价,这也是设计讨论常常难以达成共识的原因。大多数设计手法在改善一种上下文成本的同时,会恶化另一种。抽象可以把几处重复的决策合并到一个有名字的地方,从而降低广度,但它也引入了一个新概念和一道新边界,读者必须理解它们。分层架构让决策的位置变得可预测,减少了开放式搜索,但也增加了穿越各层的路径。注册表可以让分散的闭包保持可发现,但引入了一套查找机制,未来的修改者必须学会它。
正因为存在这些权衡,含糊的标签很少能平息设计分歧。同一个结构,一位工程师说它“分解得很干净”,另一位却说它“过度抽象”。分歧往往不在于他们看到的代码不同,而在于他们计算的是不同的上下文成本。一个人关注抽象避免了多少广度,另一个人关注新边界引入了多少深度。
CMP 把这种分歧改写成一个更有用的问题:对于这个系统必须支持的真实修改,这个手法增加了哪些上下文成本,又削减、迁移、索引或检查了哪些上下文成本?这个问题并不能让判断自动化,但它让隐藏的账本变得可见。设计手法不再是抽象意义上的“好”或“坏”,而是针对预期修改流的一笔交易。
有一种不对称值得指出。比较深度和广度的成本时,两者不应等量齐观,因为它们的失败方式不同:深度的失败在工作过程中就能看到,广度的失败则在交付之后才悄然发生。慢的修改仍可能是正确的,不完整的修改不可能正确。所以,为了控制真实存在的广度而付出一些可见的深度,通常是合理的。边界、注册表、类型或测试可能会增加表面成本,但只要它能防止某个闭包成员被遗漏,这份成本就是值得的。这种倾向并非绝对:为想象中的广度付出深度,就是过度设计。但当闭包真实存在时,广度通常应该占更大的权重。
再看折扣规则:一笔实际的交易
在讲广度的那一篇开头,折扣规则散落在结账界面、订单服务、计费任务和分析流水线之中。从广度的角度看,危险很清楚:未来的修改者可能只改了四处中的三处,就带着一个不易察觉的不一致上线了。借助变换的词汇,我们可以从设计的角度重新审视同一个场景。
常见的做法是引入一个有名字的抽象,例如 DiscountPolicy,并让系统中的相关部分依赖它。这是一个削减手法:它把分散的决策收拢成一个有归属的概念,未来的修改者不必再去重新发现同一规则的四种独立表示。它同时也是一个索引手法:有了这个具名类型作为锚点,每个依赖该规则的地方都只需一次“查找引用”就能找到,修改者不再需要靠 grep 和口口相传的经验去重新拼凑闭包。
但这个手法不是免费的。系统现在多了一个新概念、一道新边界,也许还多了一步追查路径。读者必须理解 DiscountPolicy 是什么意思,它的契约保证了哪些行为。换句话说,这个设计用一部分深度换掉了一部分广度。
如果新边界可靠,而原来的闭包也确实存在,这笔交易就是划算的。如果抽象含糊、浅薄或者过早,这笔交易就是亏的。这样表述之后,关于重复与抽象的争论就清楚多了:问题不在于重复和抽象哪个普遍更好,而在于新增的深度是否比它削减的广度更小、更可靠。
设计原则是上下文算子
有了深度、广度和上下文变换这几个概念,就可以用新的方式解读经典的设计原则。它们不是各自独立的审美规则,而是上下文算子。面向边界的原则主要作用于深度,通过创造停止点发挥作用。面向局部性的原则主要作用于广度,让修改闭包更小或更容易触达。架构通过让决策位置可预测,来为上下文获取指引路线。测试和语言机制让部分上下文变得可检查,使被遗漏的假设以反馈的形式出现,而不是成为静默的缺陷。
这些原则家族各自都值得单独讨论,那是第三部分的任务。本篇只负责搭建共同的框架;接下来的章节会逐一讨论主要的算子:边界、局部性、架构、测试和语言机制。